Ferramentas de inteligência artificial conseguem escrever textos, resumir informações e responder perguntas em poucos segundos. Porém, quando precisam lidar com dados internos, documentos recentes ou assuntos muito específicos, podem apresentar respostas incompletas ou incorretas. É nesse cenário que aparece o RAG, uma técnica usada para conectar modelos de IA a fontes externas de informação.
A sigla RAG vem de Retrieval-Augmented Generation, que pode ser traduzida como geração aumentada por recuperação. Em vez de depender apenas do conhecimento usado durante o treinamento do modelo, o sistema pesquisa conteúdos relevantes e utiliza esse material para formular a resposta.
Na prática, o RAG pode transformar uma ferramenta genérica em um assistente capaz de consultar manuais, políticas internas, catálogos, contratos, artigos ou bases de conhecimento. A tecnologia é útil, mas não elimina a necessidade de revisar fontes, controlar permissões e avaliar a qualidade das respostas.
O que é RAG?
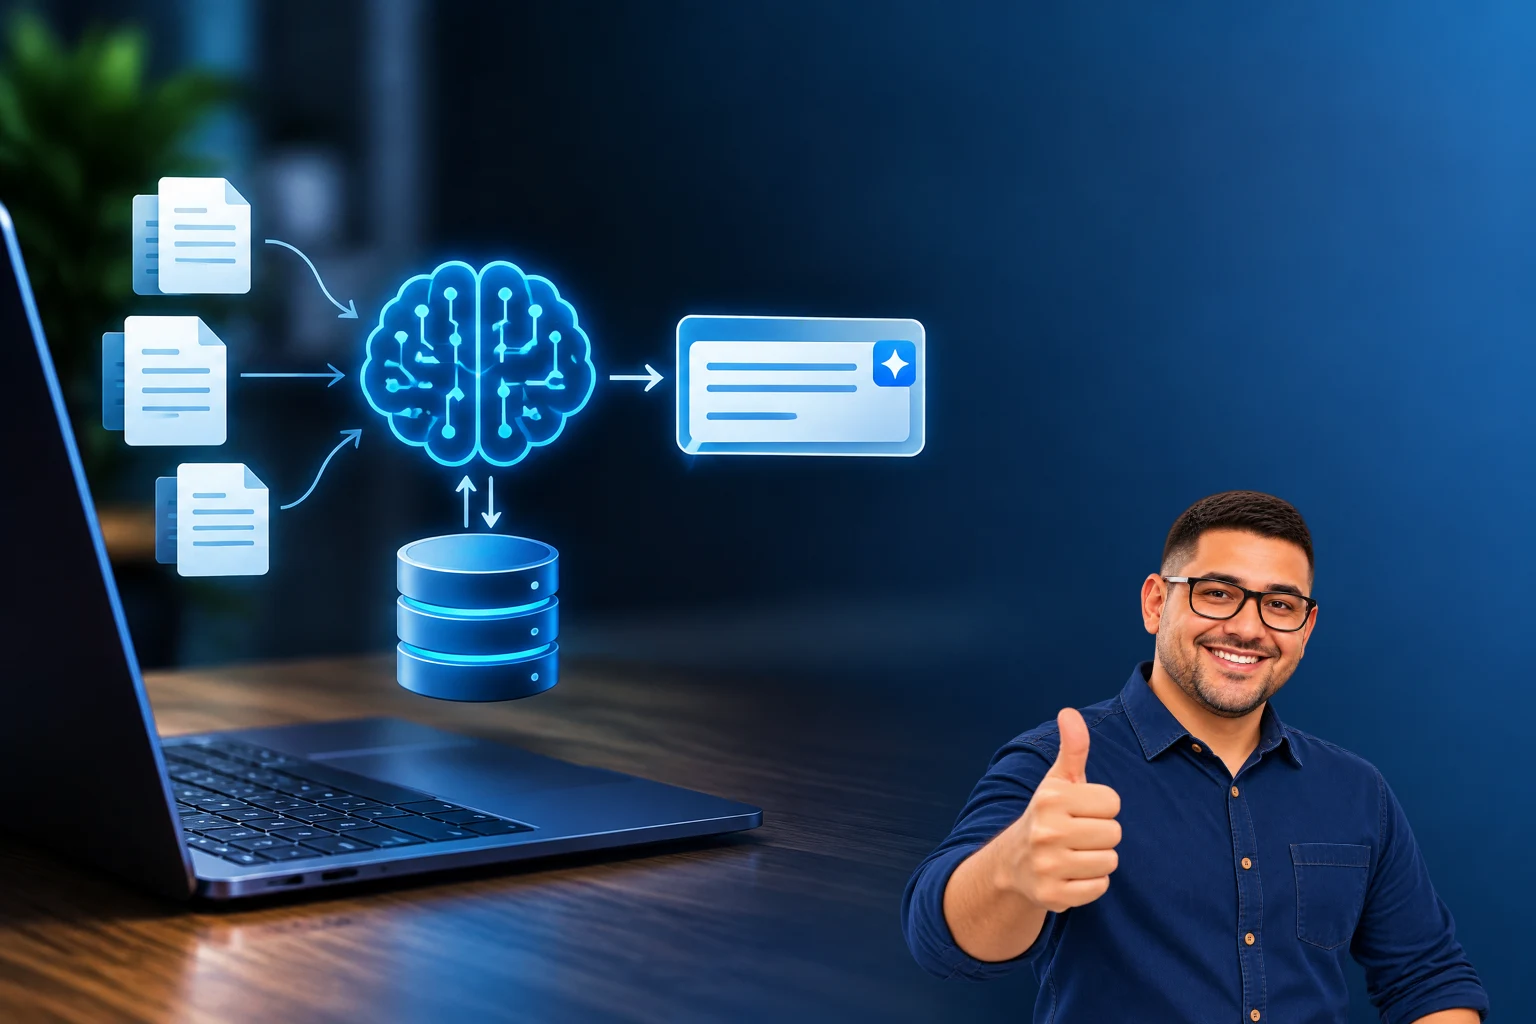
RAG é uma arquitetura que combina duas etapas principais: a recuperação de informações e a geração de texto. Primeiro, o sistema procura trechos relacionados à pergunta do usuário. Depois, envia esses trechos ao modelo de linguagem junto com a solicitação original. Com esse contexto adicional, a IA produz uma resposta mais alinhada ao conteúdo consultado.
Imagine uma empresa que possui um conjunto de documentos sobre procedimentos internos. Um chatbot comum pode não conhecer essas regras. Com RAG, os documentos são preparados e indexados. Quando alguém pergunta como solicitar determinado serviço, o sistema busca os trechos relevantes e usa essas informações para responder.
Isso não significa que o modelo esteja “aprendendo” permanentemente cada documento. Em muitos casos, ele apenas recebe o conteúdo pertinente durante aquela consulta. Essa distinção é importante: atualizar a base de dados costuma ser diferente de treinar novamente o modelo de inteligência artificial.
Como o RAG funciona na prática
Embora as implementações variem, o funcionamento costuma seguir um fluxo semelhante.
1. Reunião dos documentos
O primeiro passo é definir quais fontes serão consultadas. Elas podem incluir arquivos de texto, páginas internas, manuais, planilhas, registros de atendimento e outros materiais estruturados ou não estruturados.
Nessa fase, é importante remover versões duplicadas, identificar documentos desatualizados e organizar os conteúdos. Uma base confusa tende a produzir resultados confusos, mesmo quando o modelo de IA é avançado.
2. Divisão do conteúdo em trechos
Documentos longos geralmente são divididos em partes menores. Esses trechos precisam ter tamanho suficiente para preservar o contexto, mas não podem ser tão extensos a ponto de dificultar a busca.
Por exemplo, um manual pode ser separado por capítulos, tópicos ou blocos de parágrafos. A forma de divisão depende do tipo de material e das perguntas que os usuários costumam fazer.
3. Conversão em representações numéricas
Os trechos são convertidos em representações numéricas conhecidas como embeddings. Elas procuram capturar o significado do conteúdo, permitindo comparar a pergunta do usuário com os documentos por proximidade semântica, e não apenas por palavras exatamente iguais.
Assim, uma pergunta sobre “cancelar uma assinatura” pode encontrar um trecho que usa a expressão “encerrar o plano”, mesmo que os termos não sejam idênticos.
4. Busca dos trechos relevantes
Quando o usuário envia uma pergunta, o sistema também cria uma representação numérica dela. Em seguida, compara essa representação com os documentos indexados e seleciona os trechos considerados mais relacionados.
Algumas soluções combinam busca semântica com busca por palavras-chave. Essa combinação pode ser útil quando a consulta envolve nomes próprios, códigos, números de versão ou termos específicos.
5. Geração da resposta
Os trechos recuperados são enviados ao modelo de linguagem como contexto. O sistema pode receber instruções para responder apenas com base nas fontes encontradas, indicar quando não há informação suficiente ou citar os documentos consultados.
O modelo então organiza o conteúdo em uma resposta compreensível. Ele não apenas copia os trechos: pode resumir, explicar, comparar informações presentes na base e adaptar a linguagem ao perfil do usuário.
Qual é a diferença entre RAG e treinamento de IA?
Treinar ou ajustar um modelo significa alterar seus parâmetros para que ele aprenda padrões de um conjunto de exemplos. Esse processo pode exigir preparação de dados, capacidade computacional e avaliação técnica.
Já o RAG normalmente mantém o modelo e acrescenta uma etapa de consulta a fontes externas. Quando um documento muda, basta atualizar a base de recuperação, conforme a arquitetura utilizada, sem necessariamente treinar o modelo novamente.
As duas abordagens podem ser combinadas. Um ajuste fino pode ensinar formato, estilo ou comportamento específico, enquanto o RAG fornece informações que precisam ser consultadas e atualizadas com frequência.
| Aspecto | RAG | Treinamento ou ajuste fino |
|---|---|---|
| Objetivo principal | Consultar informações externas | Adaptar o comportamento do modelo |
| Atualização de conteúdo | Pode ocorrer pela atualização da base | Pode exigir novo processo de treinamento |
| Uso comum | Manuais, políticas e bases internas | Estilo, formato e tarefas específicas |
Onde o RAG pode ser usado
- Atendimento ao cliente: consulta a políticas, instruções de uso e perguntas frequentes.
- Suporte técnico: pesquisa em manuais, registros de erros e documentação de produtos.
- Pesquisa interna: localização de informações espalhadas por arquivos e sistemas.
- Educação: criação de assistentes baseados em materiais de uma disciplina ou curso.
- Operações: consulta a procedimentos, listas de verificação e orientações de rotina.
- Comércio eletrônico: resposta a dúvidas sobre características, compatibilidade e funcionamento de itens cadastrados.
Um exemplo simples seria um assistente para uma equipe de suporte. Em vez de responder com conhecimento genérico, ele poderia consultar a documentação oficial de cada produto, recuperar o procedimento adequado e apresentar a orientação acompanhada da fonte correspondente.
Quais são as vantagens do RAG?
Respostas mais contextualizadas
O sistema pode considerar informações específicas de uma empresa, projeto ou produto. Isso reduz a distância entre uma resposta genérica e a realidade de quem está fazendo a pergunta.
Mais facilidade para atualizar informações
Quando o conteúdo fica em uma base separada do modelo, a organização pode substituir ou acrescentar documentos. Essa característica é útil para materiais que mudam com frequência.
Possibilidade de indicar fontes
Uma implementação bem planejada pode mostrar quais documentos ou trechos foram usados. Isso facilita a conferência e ajuda o usuário a entender de onde veio a informação.
Uso de dados internos com controle
O RAG pode ser configurado para consultar repositórios privados, respeitando regras de acesso. Porém, a proteção não acontece automaticamente: é preciso definir autenticação, permissões e registros de uso.
Limitações e cuidados importantes
O RAG não garante respostas corretas por si só. Se os documentos estiverem errados, desatualizados ou mal organizados, o sistema poderá recuperar informações inadequadas. Também existe o risco de selecionar um trecho parcialmente relevante e ignorar uma exceção presente em outra parte do documento.
Outro cuidado envolve as chamadas alucinações, quando a IA produz uma afirmação que não está sustentada pelo contexto. Instruções para admitir falta de informação, limites na quantidade de fontes recuperadas e revisão humana ajudam, mas não substituem testes.
As permissões também merecem atenção. Um assistente não deve revelar dados apenas porque consegue encontrá-los. A busca precisa respeitar a identidade do usuário e as regras de acesso de cada documento.
Além disso, documentos com tabelas, imagens, colunas ou formatação complexa podem ser interpretados de maneira incompleta durante a preparação. Antes de colocar a solução em uso, vale testar perguntas reais e verificar se o conteúdo recuperado preserva o significado original.
Como avaliar uma solução baseada em RAG
- Defina o objetivo: determine quais perguntas o sistema deverá responder e quem poderá utilizá-lo.
- Organize as fontes: mantenha documentos oficiais, atualizados e com indicação clara de versão.
- Crie perguntas de teste: inclua casos simples, perguntas ambíguas e situações em que a resposta não está na base.
- Verifique as fontes: confira se os trechos recuperados realmente sustentam a resposta.
- Estabeleça revisão: defina quando uma pessoa deverá validar a informação antes de ela ser usada.
- Acompanhe os erros: registre respostas inadequadas e use esses exemplos para melhorar a base e as instruções.
FAQ sobre RAG
RAG é um tipo de inteligência artificial?
RAG é uma técnica ou arquitetura usada junto a modelos de inteligência artificial. Ele não é, necessariamente, um modelo independente.
RAG elimina as respostas erradas?
Não. A técnica pode melhorar o contexto e facilitar a consulta a fontes, mas ainda pode recuperar trechos inadequados ou gerar conclusões incorretas.
É preciso treinar um modelo para usar RAG?
Não necessariamente. Muitas soluções utilizam um modelo já existente e acrescentam uma etapa de indexação e busca em documentos externos.
RAG serve apenas para empresas?
Não. A abordagem também pode ser usada em projetos educacionais, pessoais, comunidades e aplicações que precisem consultar uma coleção específica de documentos.
Conclusão
RAG é uma forma de tornar sistemas de inteligência artificial mais úteis em tarefas que dependem de informações específicas. Ao recuperar trechos relevantes antes de gerar uma resposta, a técnica conecta modelos de linguagem a documentos e bases de conhecimento que não fazem parte do conhecimento original do modelo.
Seu resultado depende da qualidade das fontes, da configuração da busca, do controle de acesso e da avaliação contínua. Por isso, o melhor uso do RAG não é tratá-lo como uma garantia automática de verdade, mas como uma camada de consulta que ajuda a IA a responder com mais contexto e transparência.