O edge computing, também chamado de computação de borda, é uma forma de processar dados mais perto do local onde eles são gerados. Em vez de enviar todas as informações para um servidor distante ou para a nuvem, parte do processamento acontece no próprio dispositivo ou em equipamentos próximos.
Essa abordagem ganhou importância com a expansão da internet das coisas, dos dispositivos inteligentes, dos veículos conectados e de aplicações que precisam responder rapidamente. Mas o edge computing não elimina a nuvem: na prática, as duas tecnologias costumam trabalhar juntas.
O que é edge computing?
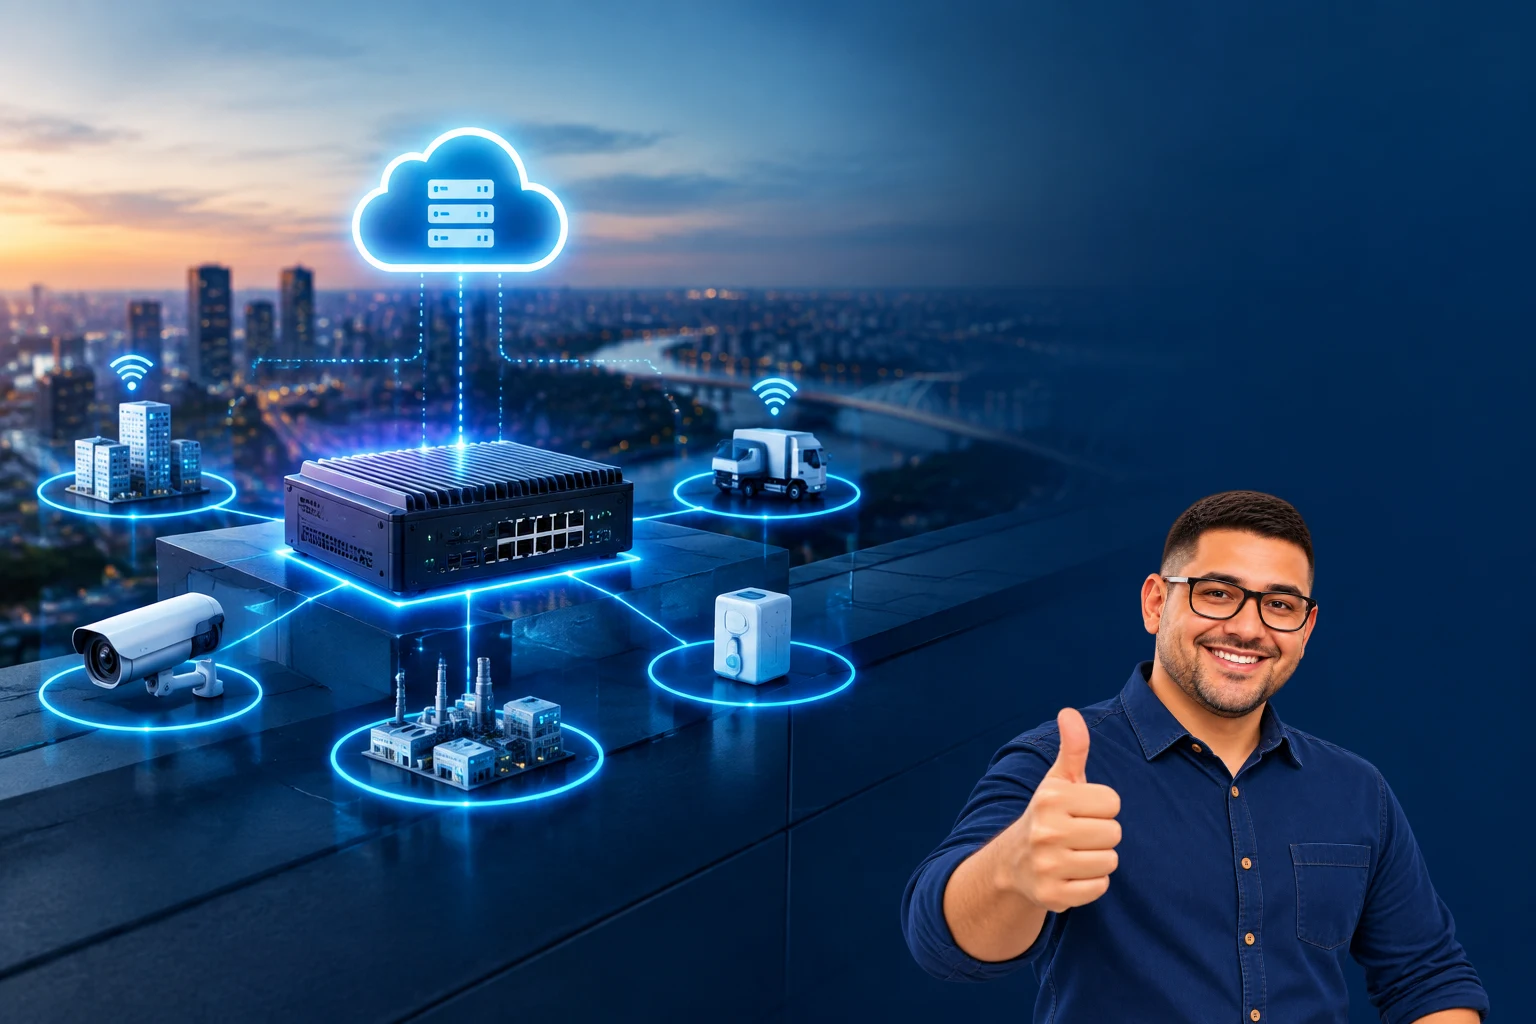
Edge computing é um modelo de computação distribuída que leva armazenamento e processamento para a “borda” da rede. Essa borda pode estar em um celular, câmera, roteador, máquina industrial, veículo ou servidor instalado próximo ao usuário.
Em um modelo tradicional, um dispositivo coleta dados e envia tudo para um data center. O servidor processa as informações e devolve uma resposta. No edge computing, o dispositivo ou um equipamento intermediário analisa parte desses dados localmente antes de decidir o que precisa ser enviado para a nuvem.
Um exemplo simples é uma câmera inteligente capaz de identificar movimento. Em vez de transmitir continuamente todo o vídeo para um servidor, ela pode analisar as imagens no próprio aparelho e enviar apenas alertas ou trechos relevantes.
Como o edge computing funciona?
O funcionamento costuma envolver três camadas principais:
- Dispositivos: sensores, câmeras, celulares, máquinas, carros e outros equipamentos que geram dados.
- Infraestrutura de borda: aparelhos ou servidores próximos que processam as informações com baixa distância de rede.
- Nuvem ou data center: ambiente usado para armazenar dados, treinar modelos, gerar relatórios e executar tarefas que exigem mais recursos.
Imagine uma fábrica com sensores que acompanham a temperatura de um equipamento. Um sistema de borda pode analisar as medições imediatamente e interromper a máquina ao detectar uma condição fora do padrão. Depois, os registros podem ser enviados à nuvem para histórico, auditoria e análise de longo prazo.
Assim, o edge computing distribui o trabalho. A nuvem continua útil para tarefas centralizadas, enquanto a borda cuida de respostas rápidas e do tratamento inicial dos dados.
Qual é a diferença entre edge computing e computação em nuvem?
A computação em nuvem concentra recursos em servidores acessados pela internet. Ela facilita a expansão de sistemas, o armazenamento de grandes volumes de dados e o acesso remoto a aplicações.
O edge computing aproxima o processamento da fonte dos dados. Seu foco principal é reduzir a distância entre o dispositivo e a decisão que precisa ser tomada.
| Aspecto | Computação em nuvem | Edge computing |
|---|---|---|
| Local do processamento | Servidores remotos ou data centers | Dispositivo ou infraestrutura próxima |
| Resposta | Pode depender da conexão e da distância | Tende a ser mais rápida em tarefas locais |
| Uso de internet | Pode exigir envio frequente de dados | Pode reduzir o volume transmitido |
| Escala | Facilmente centralizada | Distribuída entre vários pontos |
Uma solução não substitui necessariamente a outra. Muitas aplicações usam edge computing para decisões imediatas e nuvem para armazenamento, supervisão e análises mais complexas.
Quais são as vantagens do edge computing?
Menor latência
Como os dados percorrem uma distância menor, a resposta pode chegar mais rapidamente. Isso é útil em situações nas quais esperar o processamento em um servidor distante pode prejudicar a operação.
Menor dependência de conexão constante
Um equipamento de borda pode continuar executando algumas funções mesmo quando a conexão com a nuvem está instável ou temporariamente indisponível. A capacidade offline depende do projeto, mas o processamento local pode aumentar a autonomia do sistema.
Redução do tráfego de dados
Em vez de enviar tudo para a nuvem, o sistema pode filtrar, resumir ou compactar as informações. Isso ajuda a controlar o volume de dados transmitido pela rede.
Mais privacidade em determinados cenários
Quando a análise é feita localmente, alguns dados podem permanecer no dispositivo e não precisar ser enviados integralmente a um servidor externo. Isso não garante privacidade por si só, mas oferece uma alternativa de arquitetura que pode reduzir a exposição.
Respostas mais adequadas ao ambiente
Um sistema local pode considerar informações específicas do lugar onde está instalado, como sensores, equipamentos e regras da operação. Isso favorece aplicações que precisam reagir ao contexto em tempo real.
Onde o edge computing é usado?
Casas conectadas
Centrais de automação, sensores e câmeras podem executar algumas tarefas localmente. Um sistema pode acionar uma luz, identificar uma mudança no ambiente ou controlar um equipamento sem depender de uma ida constante à nuvem.
Indústria
Em ambientes industriais, a computação de borda pode acompanhar máquinas, analisar sensores e identificar padrões de funcionamento. O processamento próximo ajuda aplicações que precisam de resposta rápida e reduz o envio contínuo de dados brutos.
Veículos conectados
Carros e outros veículos possuem sensores que produzem informações em grande quantidade. Parte desses dados precisa ser interpretada localmente para apoiar recursos de assistência, navegação e monitoramento.
Varejo
Lojas podem usar câmeras, sensores e terminais conectados para analisar ocupação, fluxo de pessoas, disponibilidade de produtos e funcionamento de equipamentos. O processamento local pode diminuir o atraso entre a coleta e a ação.
Agricultura
Sensores instalados em áreas rurais podem acompanhar condições do solo, clima e irrigação. Quando a conexão é limitada, processar dados perto do local de coleta pode ser especialmente útil.
Hospitais e laboratórios
Equipamentos conectados podem usar análise local para monitoramento e classificação de informações. Em aplicações sensíveis, a arquitetura precisa ser planejada com rigor, incluindo proteção de dados, controle de acesso e validação dos resultados.
Quais são os desafios do edge computing?
Apesar dos benefícios, levar processamento para muitos pontos também aumenta a complexidade do ambiente tecnológico.
- Gerenciamento distribuído: cada dispositivo ou servidor de borda precisa ser atualizado, monitorado e configurado.
- Segurança física: equipamentos instalados fora de data centers podem ficar mais expostos a acesso indevido ou danos.
- Recursos limitados: um sensor ou dispositivo compacto normalmente tem menos capacidade que um servidor central.
- Padronização: sistemas de fabricantes diferentes podem ter dificuldades para trocar dados e operar em conjunto.
- Manutenção: falhas em pontos espalhados podem exigir atendimento local ou ferramentas de gerenciamento remoto.
- Privacidade e governança: é necessário definir quais dados serão processados, armazenados e transmitidos.
Por isso, uma implementação bem-sucedida exige mais do que instalar dispositivos conectados. É preciso planejar a arquitetura, os mecanismos de atualização, os registros de atividade e os procedimentos para falhas.
Edge computing é a mesma coisa que inteligência artificial na borda?
Não. Edge computing é a arquitetura que permite processar dados perto da origem. A inteligência artificial na borda, também chamada de edge AI, é uma aplicação possível desse modelo.
Uma câmera pode usar um modelo de inteligência artificial localmente para reconhecer objetos, por exemplo. Nesse caso, o edge computing fornece o ambiente de processamento, enquanto a inteligência artificial executa a tarefa de análise.
Como saber se uma aplicação precisa de edge computing?
A tecnologia pode fazer sentido quando a aplicação precisa de resposta rápida, funciona em locais com conexão limitada, gera muitos dados ou possui requisitos específicos de privacidade. Também pode ser útil quando enviar tudo para a nuvem aumenta custos operacionais ou sobrecarrega a rede.
Por outro lado, uma aplicação simples, com poucos dados e sem necessidade de resposta imediata, talvez funcione melhor com uma arquitetura centralizada. A escolha depende do objetivo, do orçamento, da infraestrutura disponível e do nível de confiabilidade exigido.
FAQ sobre edge computing
Edge computing precisa de internet?
Nem sempre para todas as funções. Um sistema pode processar tarefas localmente sem conexão contínua, mas a internet pode ser necessária para sincronização, atualizações, acesso remoto e envio de informações à nuvem.
Edge computing substitui a nuvem?
Não necessariamente. O modelo mais comum combina os dois recursos: a borda cuida de respostas locais e a nuvem concentra armazenamento, administração e análises amplas.
Celular é um dispositivo de edge computing?
Pode ser. Um celular processa dados localmente, executa aplicações e pode analisar informações sem enviar tudo a um servidor. A classificação depende do contexto da arquitetura utilizada.
Edge computing é mais seguro?
Ele pode reduzir a exposição de determinados dados, mas também cria mais pontos que precisam ser protegidos. A segurança depende de autenticação, atualizações, criptografia, controle de acesso e monitoramento.
Conclusão
O edge computing aproxima o processamento dos dispositivos que geram dados. Com isso, pode reduzir atrasos, diminuir o tráfego de rede e manter algumas funções operando mesmo diante de limitações de conexão.
A tecnologia já pode ser aplicada em casas conectadas, fábricas, veículos, lojas e sistemas de monitoramento. Seu maior potencial aparece quando rapidez, autonomia e tratamento local de informações são importantes. Ainda assim, a computação de borda não deve ser vista como substituta automática da nuvem, mas como uma peça complementar em arquiteturas mais distribuídas e eficientes.