Quando um programa falha, a mensagem exibida nem sempre aponta diretamente para a linha que causou o problema. Em muitos casos, o sistema apresenta um stack trace: uma sequência de chamadas de funções, métodos ou arquivos que mostra o caminho percorrido pelo código até o erro.
Saber interpretar esse relatório ajuda a investigar falhas com mais objetividade. Em vez de testar alterações aleatórias, você consegue identificar o tipo da exceção, localizar o ponto mais relevante e verificar quais dados levaram o programa àquele estado.
O que é um stack trace
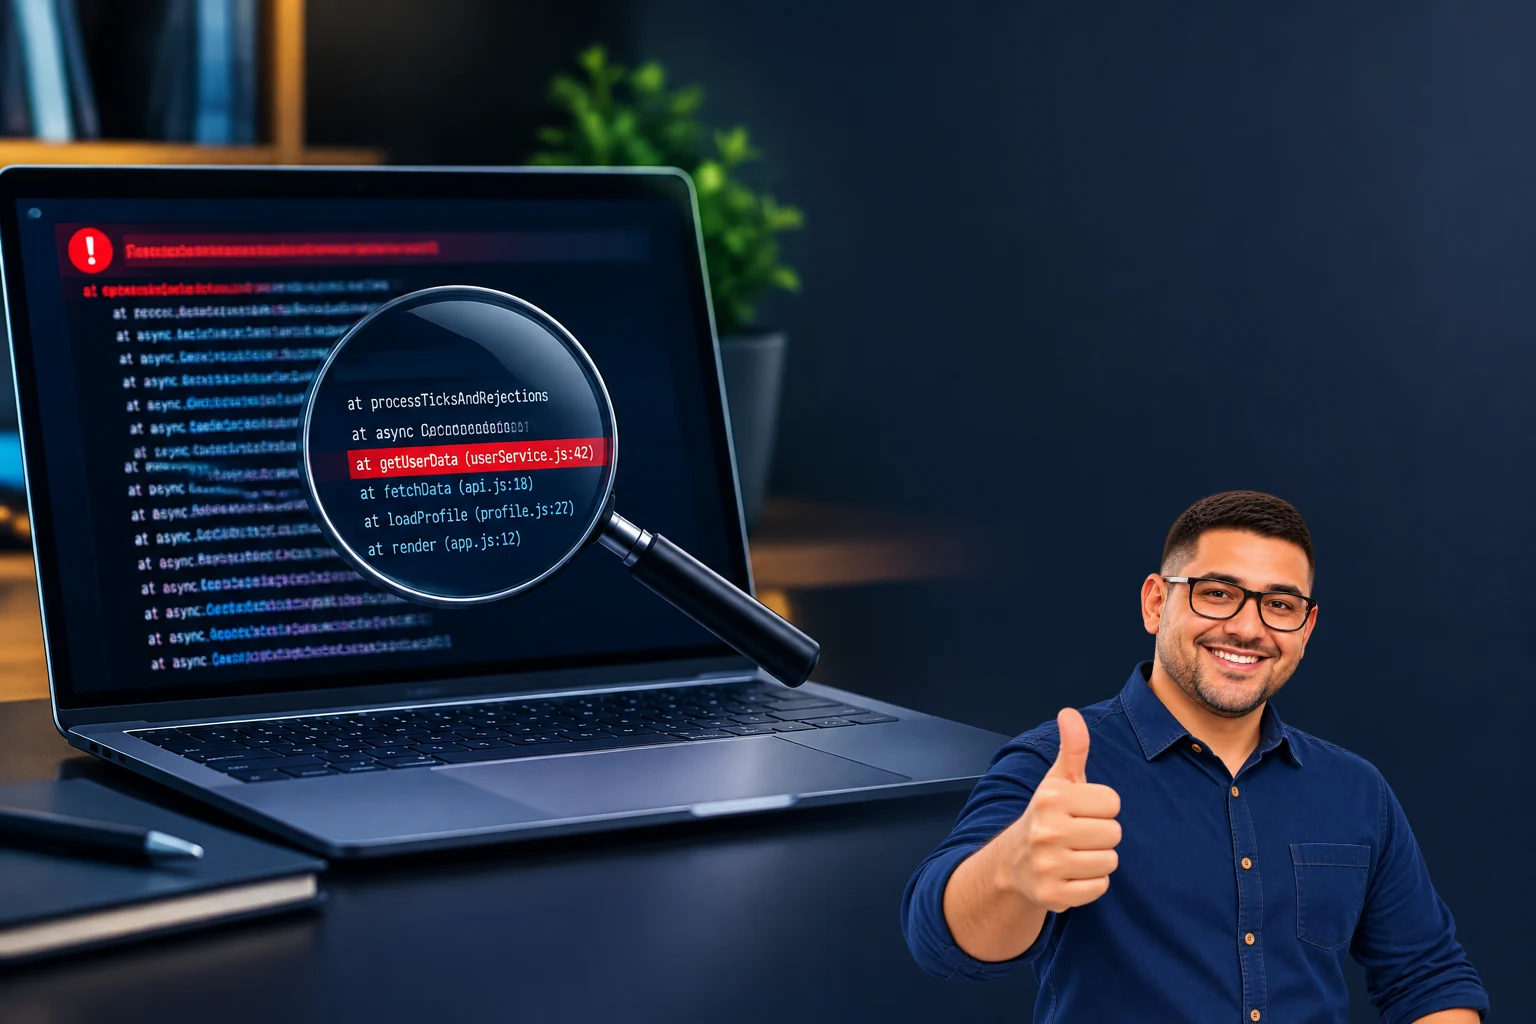
O stack trace, também chamado de rastreamento da pilha, é um registro da sequência de chamadas que estavam ativas quando uma exceção ocorreu. Cada chamada adiciona uma camada à pilha de execução. Quando o erro interrompe o fluxo, essas camadas são exibidas para mostrar como o programa chegou ao ponto da falha.
Um exemplo simplificado pode ser parecido com este:
TypeError: Cannot read properties of undefined
    at calcularTotal (pedido.js:18:22)
    at finalizarPedido (checkout.js:42:9)
    at processarCompra (app.js:75:5)
A primeira linha normalmente apresenta o tipo e a descrição do erro. As linhas seguintes indicam funções, arquivos e posições do código relacionadas à chamada que levou à exceção.
Como ler cada parte da mensagem
1. Comece pelo tipo do erro
O tipo indica a categoria do problema. Erros como TypeError, ReferenceError, ValueError, NullPointerException e FileNotFoundError sugerem caminhos diferentes de investigação.
Um erro de referência pode indicar que uma variável não existe ou está fora do escopo. Um erro de tipo costuma aparecer quando o código tenta usar um valor de maneira incompatível, como chamar um método em um valor nulo. Já um erro relacionado a arquivo pode envolver caminho incorreto, arquivo ausente ou permissão inadequada.
2. Leia a descrição com atenção
A descrição complementar pode revelar o que o programa esperava e o que recebeu. Mensagens como “valor nulo”, “chave não encontrada” ou “método não definido” são pistas sobre o estado dos dados no momento da falha.
Não descarte a mensagem por ela parecer genérica. Mesmo uma frase curta pode indicar se o problema está nos dados de entrada, na configuração, no fluxo de execução ou na própria lógica do programa.
3. Observe arquivo, linha e coluna
Uma entrada como pedido.js:18:22 geralmente representa o arquivo, a linha e a coluna aproximada do ponto indicado. Abra o arquivo nessa posição e examine não apenas a instrução destacada, mas também as linhas imediatamente anteriores.
A linha apontada pode ser apenas o local em que o erro foi percebido. O valor inválido pode ter sido criado antes, recebido de outra função ou transformado por uma operação intermediária.
Qual linha deve ser investigada primeiro
Em muitos ambientes, a parte mais útil está próxima do início do stack trace, depois da mensagem principal. Ela costuma apontar para o primeiro trecho do seu próprio código em que a exceção se manifestou.
As linhas seguintes mostram quem chamou aquela função. Elas ajudam a entender o caminho percorrido, mas nem sempre são a origem do defeito. Também é comum que o rastreamento inclua várias chamadas internas de bibliotecas ou do próprio ambiente de execução.
Uma forma prática de separar as informações é:
- Mensagem inicial: identifica o tipo e o resumo do erro.
- Primeiro arquivo do seu projeto: geralmente é o melhor ponto de partida.
- Chamadas anteriores: mostram como a função foi alcançada.
- Arquivos de bibliotecas: devem ser analisados quando o problema parece estar na integração ou no uso da biblioteca.
Como descobrir a causa real do erro
Depois de localizar a linha indicada, faça perguntas sobre os valores usados naquele ponto. Se o código acessa uma propriedade, verifique se o objeto realmente existe. Se chama uma função, confirme se o valor é de fato uma função. Se percorre uma lista, confira se a lista foi carregada e se contém o formato esperado.
Também é importante comparar o caminho de sucesso com o caminho de falha. Talvez o erro aconteça somente quando a resposta de um serviço vem vazia, quando um campo é opcional ou quando uma entrada contém um formato diferente.
Durante a investigação, registre informações úteis antes da linha problemática. Dependendo do ambiente, isso pode ser feito com um depurador, uma saída temporária ou um log controlado. Evite imprimir dados sensíveis e remova o código de diagnóstico quando a análise terminar.
Exemplo prático de interpretação
Imagine que uma aplicação mostre:
KeyError: 'email'
    at montarPerfil (usuario.py:27)
    at criarSessao (login.py:54)
A mensagem indica que o programa tentou acessar a chave email, mas ela não estava disponível. A primeira ação é abrir usuario.py na linha 27 e verificar a estrutura recebida pela função montarPerfil.
Em seguida, vale investigar de onde veio esse objeto. A função pode estar recebendo um cadastro incompleto, uma resposta com outro nome de campo ou um dicionário construído sem a chave esperada. A correção pode envolver validar a entrada, ajustar o nome usado no código ou tratar a ausência do campo de maneira explícita.
O erro não deve ser corrigido simplesmente adicionando um valor padrão sem entender o motivo da ausência. Um valor padrão pode evitar a interrupção, mas também esconder um problema no processo que monta ou fornece os dados.
Quando o stack trace aponta para uma biblioteca
Nem todo rastreamento termina em um arquivo criado pela equipe. Às vezes, a mensagem aponta para um pacote, framework ou componente externo. Isso não significa automaticamente que a biblioteca esteja com defeito.
Verifique primeiro como ela foi chamada. Parâmetros em formato incorreto, configurações incompletas e versões incompatíveis podem fazer uma biblioteca falhar internamente. Consulte a documentação da versão usada e compare o exemplo mínimo com a implementação real.
Se o erro puder ser reproduzido com poucos elementos, crie um caso mínimo. Remova telas, integrações e etapas que não participam do problema. Quanto menor o exemplo, mais fácil será distinguir um erro de uso de uma falha no componente externo.
Erros comuns ao analisar um stack trace
- Alterar várias partes ao mesmo tempo: isso dificulta saber qual mudança teve efeito.
- Considerar apenas a última linha: ela pode mostrar uma chamada interna, e não a origem do problema.
- Ignorar os dados de entrada: muitos erros surgem de valores inesperados, não da instrução isolada.
- Apagar a mensagem original: copie o erro completo antes de tentar corrigi-lo.
- Tratar o sintoma sem validar a causa: ocultar uma exceção pode apenas transferir o problema para outra etapa.
Um método rápido para investigar
- Reproduza o erro e anote o passo a passo que leva até ele.
- Copie a mensagem completa, incluindo tipo, arquivo, linha e chamadas.
- Leia a primeira linha para entender a categoria do problema.
- Abra o primeiro arquivo do seu projeto indicado no rastreamento.
- Inspecione os valores usados nessa linha e nas instruções anteriores.
- Volte para a função que chamou o trecho e confirme os argumentos recebidos.
- Faça uma alteração pequena e verificável.
- Execute novamente o mesmo cenário e confirme se o comportamento mudou.
Esse processo funciona melhor quando cada tentativa tem uma hipótese clara. Por exemplo: “o campo está ausente quando a resposta vem vazia” é uma hipótese testável; “vou mudar essa condição para ver se funciona” tende a gerar investigação confusa.
Como evitar stack traces difíceis de entender
O próprio código pode facilitar futuras investigações. Use nomes claros para funções e variáveis, valide entradas nas fronteiras do sistema e lance mensagens de erro que expliquem o contexto sem expor informações privadas.
Também ajuda dividir funções muito extensas, preservar a causa original ao tratar uma exceção e manter configurações diferentes para desenvolvimento e produção. Em ambientes que reduzem ou transformam o código, verifique se há mecanismos para relacionar o arquivo executado ao código-fonte original.
FAQ sobre stack trace
O stack trace sempre mostra a linha que causou o erro?
Não necessariamente. Ele mostra onde a exceção foi percebida e o caminho das chamadas. A causa pode estar em uma função anterior, em um dado inválido ou em uma configuração usada antes da linha destacada.
Devo corrigir sempre a primeira linha do meu código exibida?
Ela é um bom ponto de partida, mas precisa ser analisada junto com os valores recebidos e com a função que fez a chamada. A linha pode apenas revelar um problema criado anteriormente.
Posso compartilhar um stack trace para pedir ajuda?
Sim, mas remova senhas, tokens, dados pessoais, endereços internos e informações confidenciais. Preserve o tipo do erro, o trecho relevante e o contexto necessário para reproduzi-lo.
Conclusão
Interpretar um stack trace é transformar uma mensagem de falha em uma sequência de pistas. Ao identificar o tipo do erro, localizar o primeiro trecho do seu código e conferir os dados envolvidos, você reduz tentativas aleatórias e chega mais rápido à causa provável.
Com prática, o rastreamento deixa de ser um bloco confuso de texto e passa a funcionar como um mapa do caminho percorrido pelo programa até o problema.